如何在 Mac 上搜索数百个 PDF,包括扫描件
· 阅读需 7 分钟
如果要在几百份 PDF 里找一句话,正确做法不是逐个打开文件按 Command-F,而是先确认每份 PDF 是否有可搜索的文本层,再建立覆盖整个资料库的全文索引。扫描 PDF 只有页面图像,必须先做 OCR;有文本层的 PDF 才能稳定进入跨文档搜索。
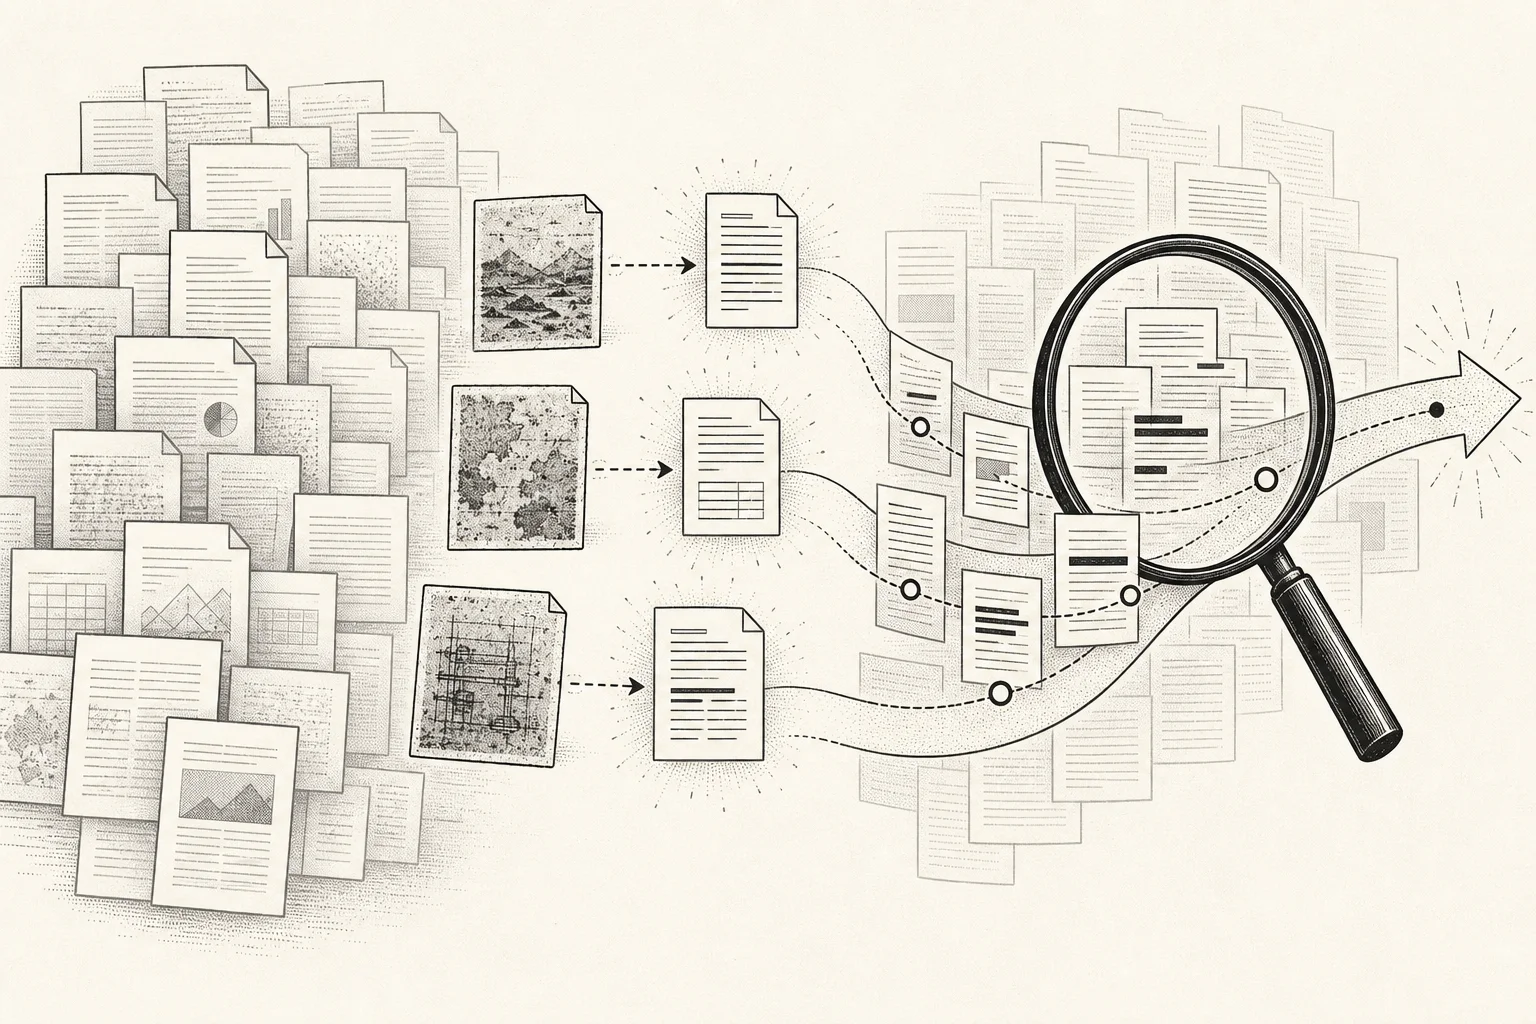
如果要在几百份 PDF 里找一句话,正确做法不是逐个打开文件按 Command-F,而是先确认每份 PDF 是否有可搜索的文本层,再建立覆盖整个资料库的全文索引。扫描 PDF 只有页面图像,必须先做 OCR;有文本层的 PDF 才能稳定进入跨文档搜索。
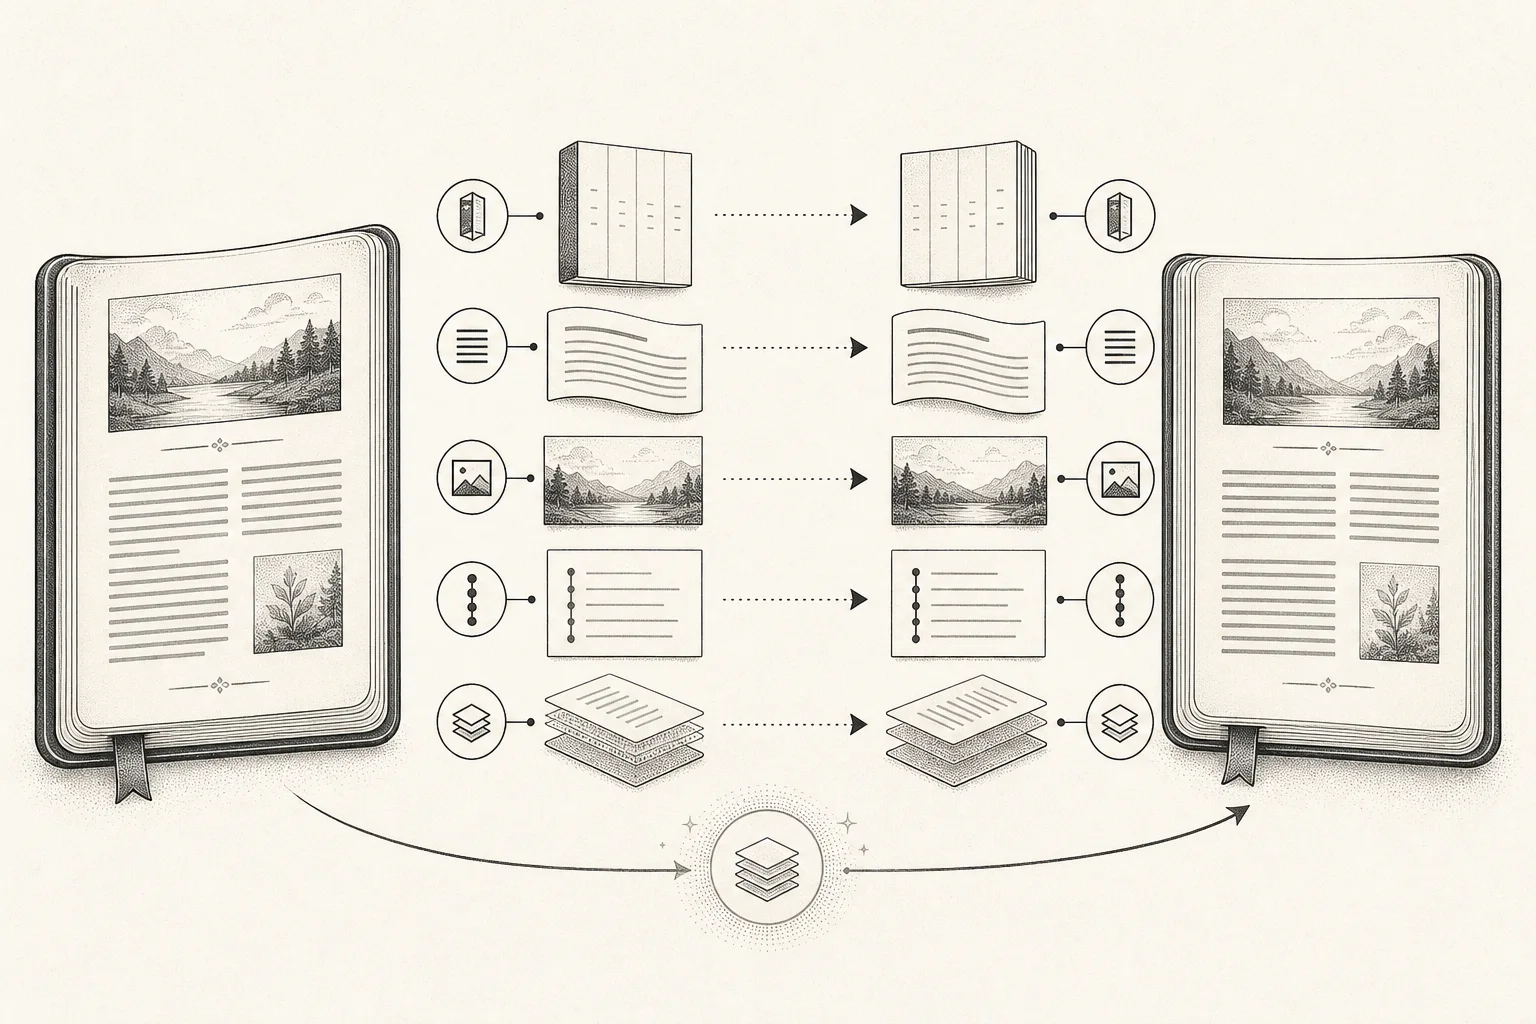
要翻译 EPUB 又保留格式,关键不是“把文字翻译完”,而是始终在 EPUB 的章节结构内处理文字:保留目录、阅读顺序、图片、链接和样式资源,只替换或补充需要翻译的正文段落,最后重新导出可验证的 EPUB。
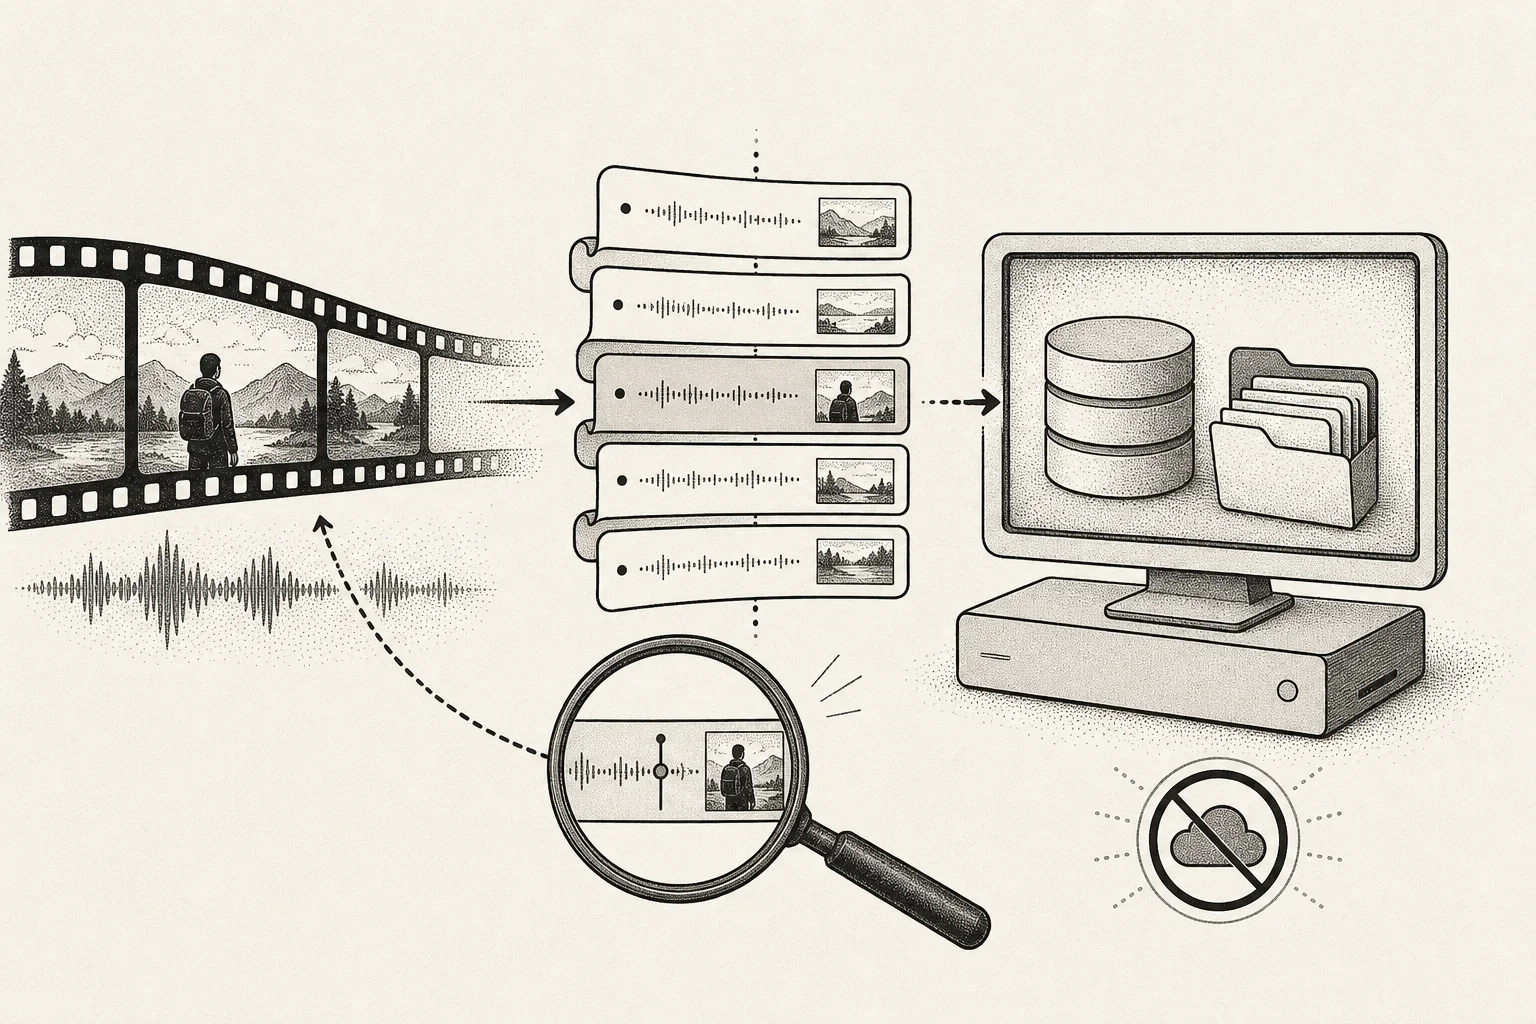
要离线搜索视频内容,需要先把语音转换成带时间戳的字幕,再搜索字幕文本。真正有用的结果不只是“这段话出现过”,还应该保存开始和结束时间,让你点击命中后直接回到视频里的那一刻。
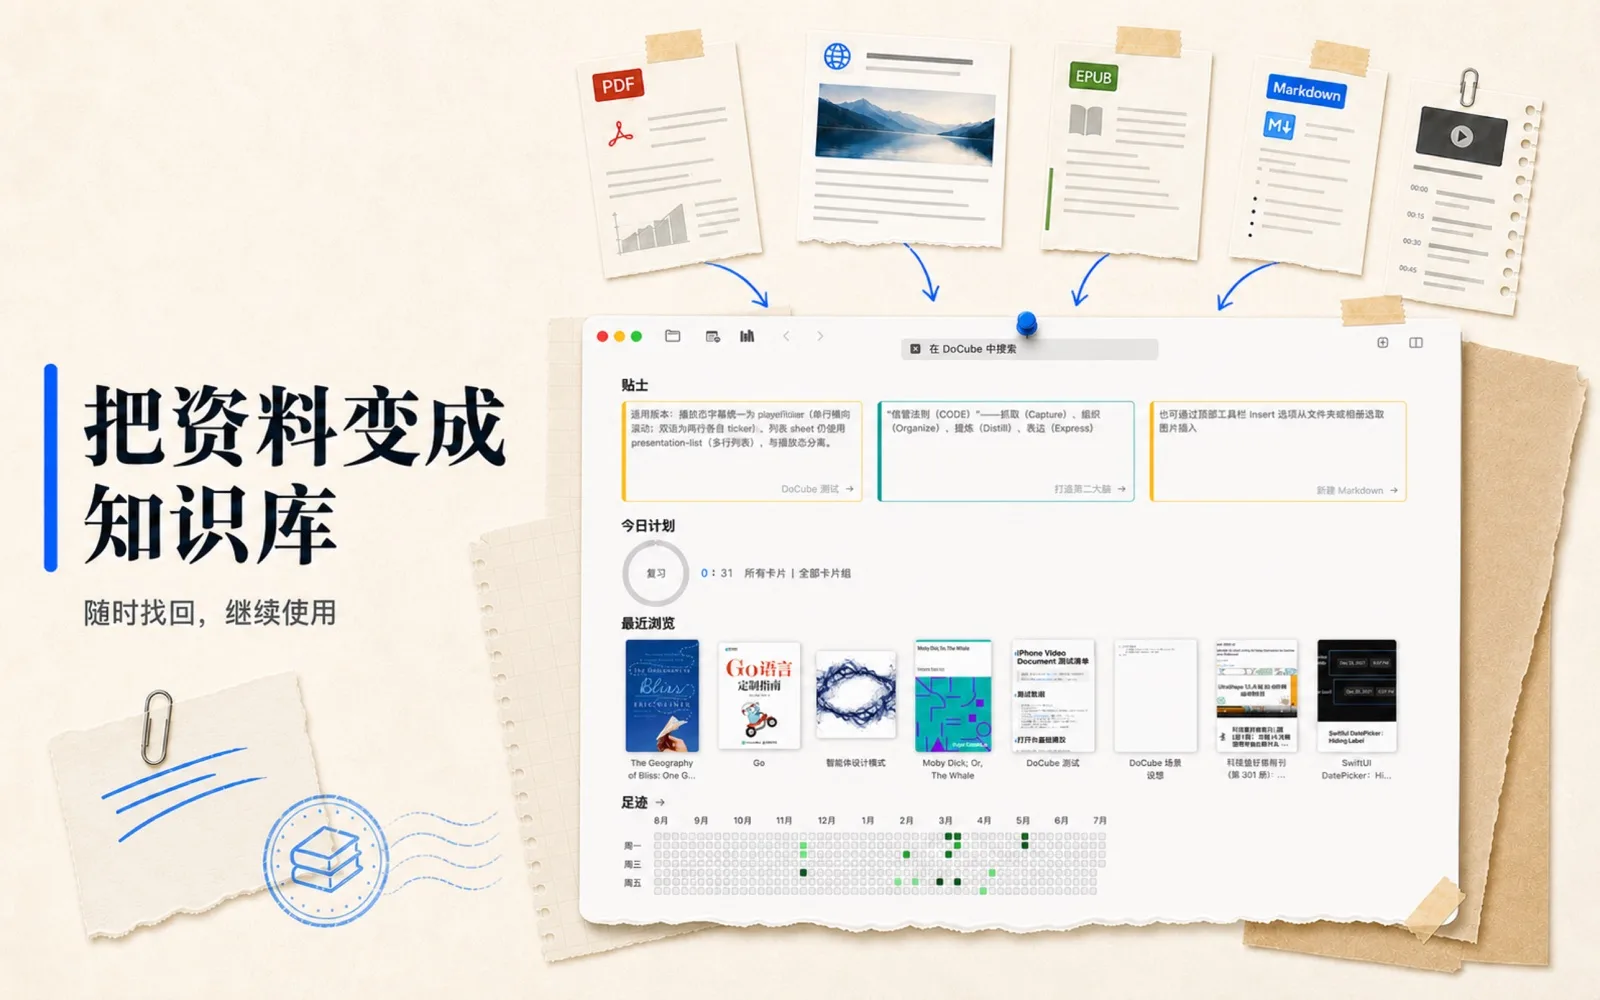
在本地管理 PDF 和 EPUB 笔记,最稳妥的方式是把“原始文档、阅读位置、标注、长笔记和搜索索引”分开保存,但让它们通过稳定的文档身份和位置重新连接。文件夹只负责归类,真正决定以后能否找回内容的是位置、结构和导出能力。
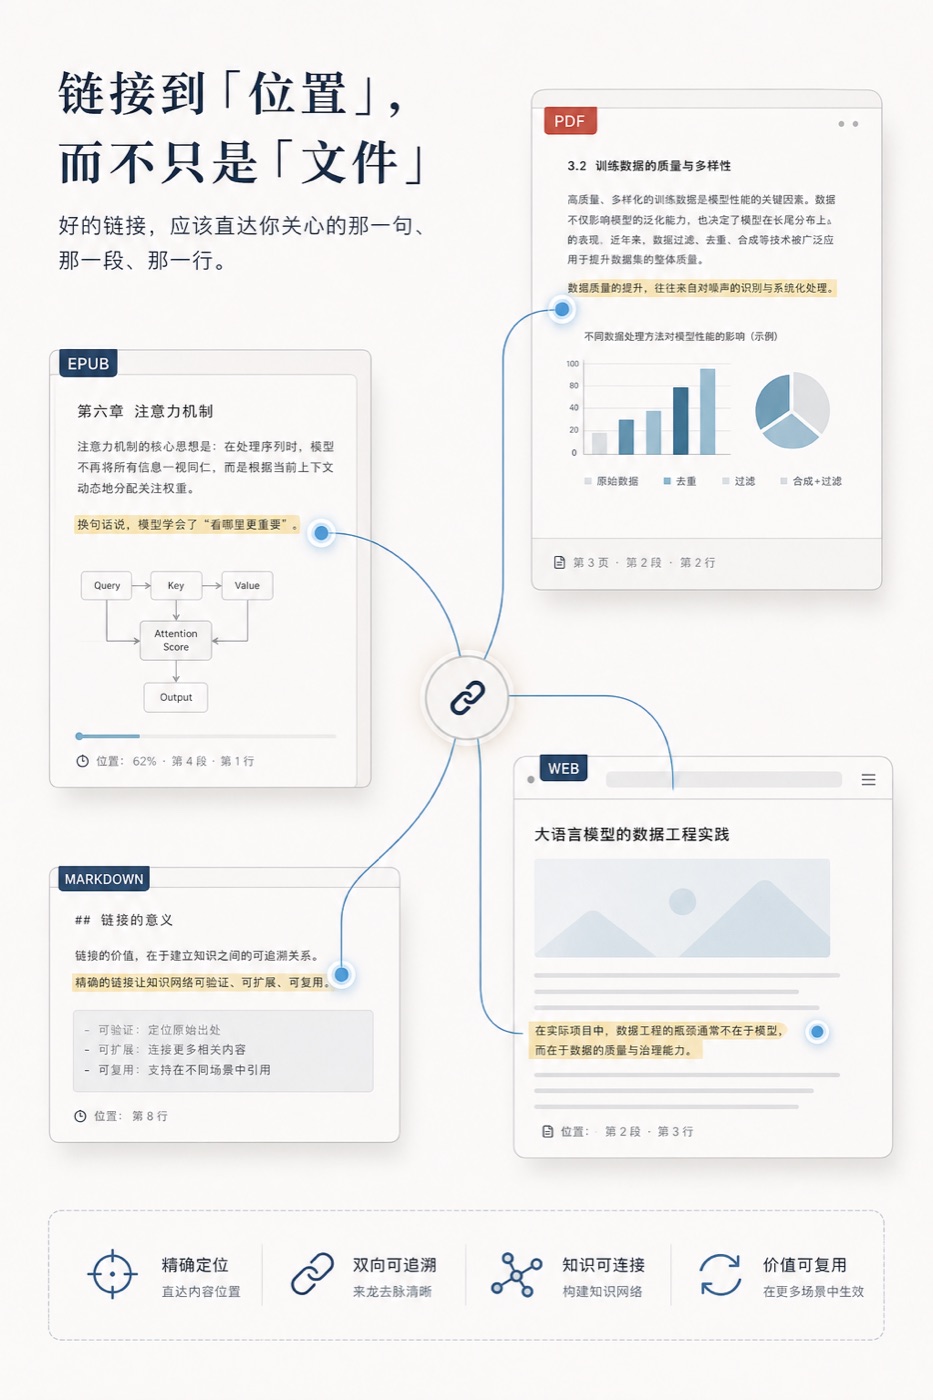
把笔记链接回 PDF 或 EPUB 的关键,是保存“文档身份 + 内容位置”,而不是只保存文件名或书名。PDF 链接应尽量落在页内位置,EPUB 链接应跟随章节和正文位置;把这个地址贴进独立笔记后,点击即可回到原始证据。
PDF 在表达能力和渲染稳定性上早已足够强。真正显得落后的,是标注之后,这些内容如何继续参与学习、研究和知识工作。
PDF 从来都不是一个没人抱怨的格式。
但我越来越觉得,很多抱怨并没有命中真正的问题。
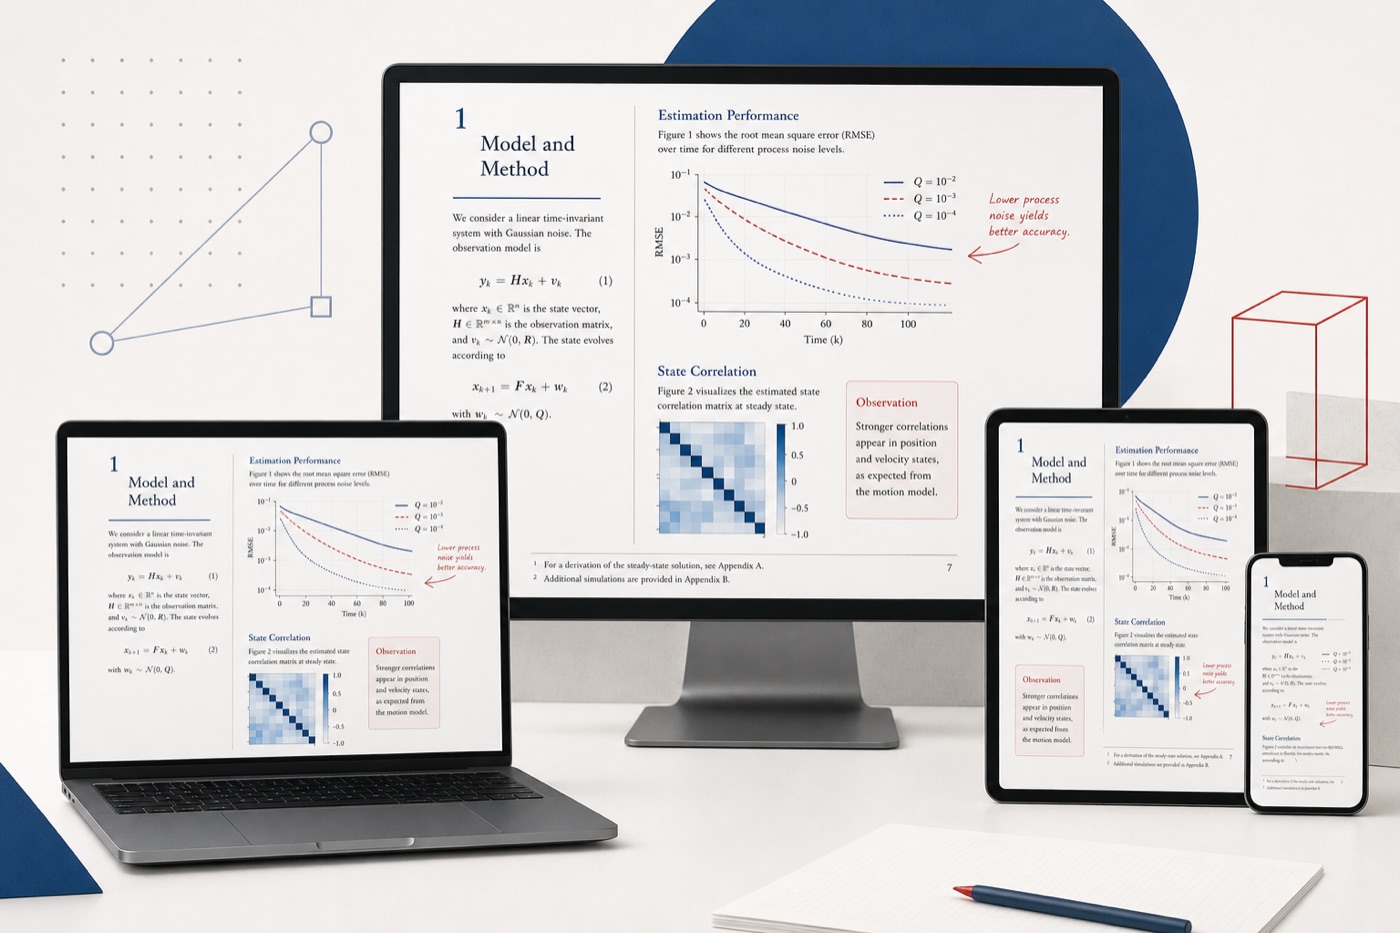
我并不讨厌 PDF。恰恰相反,我认为 PDF 至今仍是一种非常出色的文档格式。它表现力丰富、版式稳定、在不同设备上渲染一致。对于论文、报告、判决书、扫描书这类对版式敏感的文档来说,这种稳定不是缺点,反而是它至今有用的主要原因之一。复杂排版、图表、脚注、公式和页面之间的关系,都能被相当忠实地保留下来。如果目标是准确地把内容交付给读者,PDF 至今仍做得很好。